Cuando la información sensible no puede salir de la empresa
IA privada y RAG en cloud o local para empresas
Desplegamos modelos de IA de código abierto en servidores de la empresa o en nube privada, conectados a datos internos y desarrollamos RAG a medida.
¿Qué es una IA privada?
Una IA privada es un sistema de inteligencia artificial desplegado dentro de infraestructura que controla la empresa, en lugar de enviar la información a una IA comercial externa como Claude, ChatGPT o Gemini. El modelo se ejecuta en un servidor local o en una nube privada, lo cual permite mantener la privacidad de la información.
No es excluyente usar también modelos comerciales en un mismo proyecto. A veces es razonable combinar ambos sistemas, decidir qué procesos gestionan información sensible y trabajar de forma diferente para cada tipología. En cualquier caso, en nuestras implantaciones dejamos las aplicaciones preparadas para cambiar de modelo sin modificar el código.
¿En qué proyectos resulta interesante usar una IA privada?
Principalmente cuando la información no puede salir de la organización o cuando la IA forma parte de un producto propio.
Empresas con control estricto y cumplimiento normativo
Salud, finanzas, aseguradoras, despachos o gestorías tratan datos de categorías especiales o protegidos por el secreto profesional. Interesa reducir los posibles riesgos de privacidad. Con una IA privada es posible demostrar dónde está la información y quién accede a ella.
Empresas que ofrecen un producto propio que incluye IA
La IA se integra como parte de la herramienta para potenciar sus funcionalidades y se integra con un desarrollo a medida con el resto del producto. De este modo, no hay una dependencia directa del precio, condiciones ni los cambios de un proveedor de IA comercial. Podemos determinar en todo momento qué modelo usar y cuándo actualizarlo, teniendo en cuenta además que los datos no pasan por servicios externos. En Gilsys hemos desarrollado productos SaaS para nuestros clientes, teniendo en cuenta que el modelo elegido debe tener una licencia que permita el uso comercial.
Startups
Las startups valoran poder validar el producto que van a lanzar con un coste de IA previsible. Con IA privada en cloud, se alquila la GPU, no se paga por cada consulta y el precio depende de la capacidad de cómputo. Además, la IA privada en la nube encaja muy bien en fases MVP de un desarrollo por fases.
Entidades sociales y organizaciones con datos sensibles
Expedientes, informes sociales o datos de salud de personas vulnerables, que no pueden salir de la organización. Es el caso real que explicamos más abajo.
Industria
Plantas donde la conexión a internet no siempre es fiable pueden instalar una IA en local, pudiendo funcionar aunque no dispongan de conexión a internet. Entramos en detalles en IA para la industria.
Administraciones públicas
Datos de la ciudadanía que se prefieren almacenar bajo control, con un coste previsible que se puede presupuestar.
Diferencias entre IA privada e IA comercial
Son soluciones que no compiten en lo mismo. Un modelo comercial es multimodal, con altas competencias en muchos ámbitos, mientras que una IA privada se dimensiona para lo que necesita la empresa.
IA comercial: multimodal
Por ejemplo, ChatGPT, Gemini o Claude
Son modelos enormes, que funcionan en centros de datos con un coste de infraestructura muy alto, pero ese coste queda repartido entre millones de usuarios que pagan por uso.
- Disponen de conocimientos muy avanzados en muchos ámbitos.
- Procesan texto, imágenes, audio e incluso vídeo en muchos casos.
- La información que se les envía sale de la empresa. Hay que revisar periódicamente las políticas de privacidad de cada contrato.
IA privada: especializada
Modelos de código abierto, más pequeños
La mayoría de empresas no tiene presupuesto para una infraestructura equivalente a la de un modelo comercial, pero tampoco es necesario. Se escoge un modelo más pequeño, limitado al máximo para las tareas que se requieren.
- Para procesar únicamente texto, no es necesario que tenga capacidades de procesado de imágenes.
- Para analizar datos numéricos, no es necesario disponer de conocimientos de historia.
- Dispone de menos parámetros (término con el que se mide una IA), pero así puede funcionar en un servidor asequible y responder bien dentro de su ámbito.
- La información no sale de la infraestructura de la empresa.
¿Qué información compartir con un modelo comercial?
Con un servicio comercial, el RGPD se cumple en base al contrato que ofrece el proveedor. Hay que revisar dónde procesa los datos, si se usan para entrenar modelos y cuánto tiempo quedan almacenados. Con una IA privada, se depende solo de la empresa.
Información que puede ir a un modelo comercial
Textos de marketing, solicitudes de resumen de artículos públicos, traducciones de fichas de producto o datos técnicos, generar ideas o código genérico. Ninguna de estas tareas identifica a personas ni compromete a la empresa.
Información que no debería salir de la empresa sin revisar RGPD y normas internas
Currículums, expedientes, fichas de cliente, historiales, informes internos con cifras reales o cualquier documento con datos de categorías especiales.
Los grandes proveedores, como Microsoft o Google, ofrecen servicios especializados para procesar documentos como facturas o tickets. Los procesan en Europa y tienen políticas de retención que permiten cumplir con la privacidad. Lo explicamos en análisis confidencial de documentos.
¿Dónde se instala una IA privada?
IA privada en cloud o en servidor local
En los servidores de la empresa
Tiene sentido cuando la empresa ya tiene infraestructura para hospedar servidores propios y un equipo de IT que los mantenga. Aparte del nuevo servidor, no supone una inversión adicional en hardware. Es la opción con más control ya que la información no sale de la red, ni siquiera cifrada.
En una nube privada con GPU de alquiler
Alquilar una máquina con tarjeta gráfica dedicada a la empresa es asequible y no obliga a invertir en infraestructura. Es lo habitual en un producto SaaS y en las startups que deseen ofrecer servicios de inteligencia artificial propios.
Sistemas híbridos
Una empresa puede tener diferentes proyectos e incluso cada proyecto puede usar varios modelos de IA. Para cada modelo, se puede trabajar con un sistema privado local, cloud o comercial. En este escenario, las funciones con información sensible pueden enrutarse hacia un modelo privado y las demás pueden usar uno comercial, que suele ser más capaz y económico.
RAG: ofrecemos a la IA el contexto de la empresa
Previo procesado de la información, podemos consultarla con lenguaje natural
El objetivo es poder preguntar en lenguaje natural sobre la información de la empresa (manuales, procedimientos, fichas técnicas o contratos) y que la respuesta proceda de sus documentos, no del conocimiento general del modelo.
No hace falta entrenar un modelo desde cero: es inviable, exige cantidades enormes de datos y de cálculo. Para ello, se selecciona un modelo (el que se considere más adecuado para cada caso) y se le proporciona acceso a la documentación de la empresa en el momento de responder. Así, cuando un dato cambia, la respuesta también.
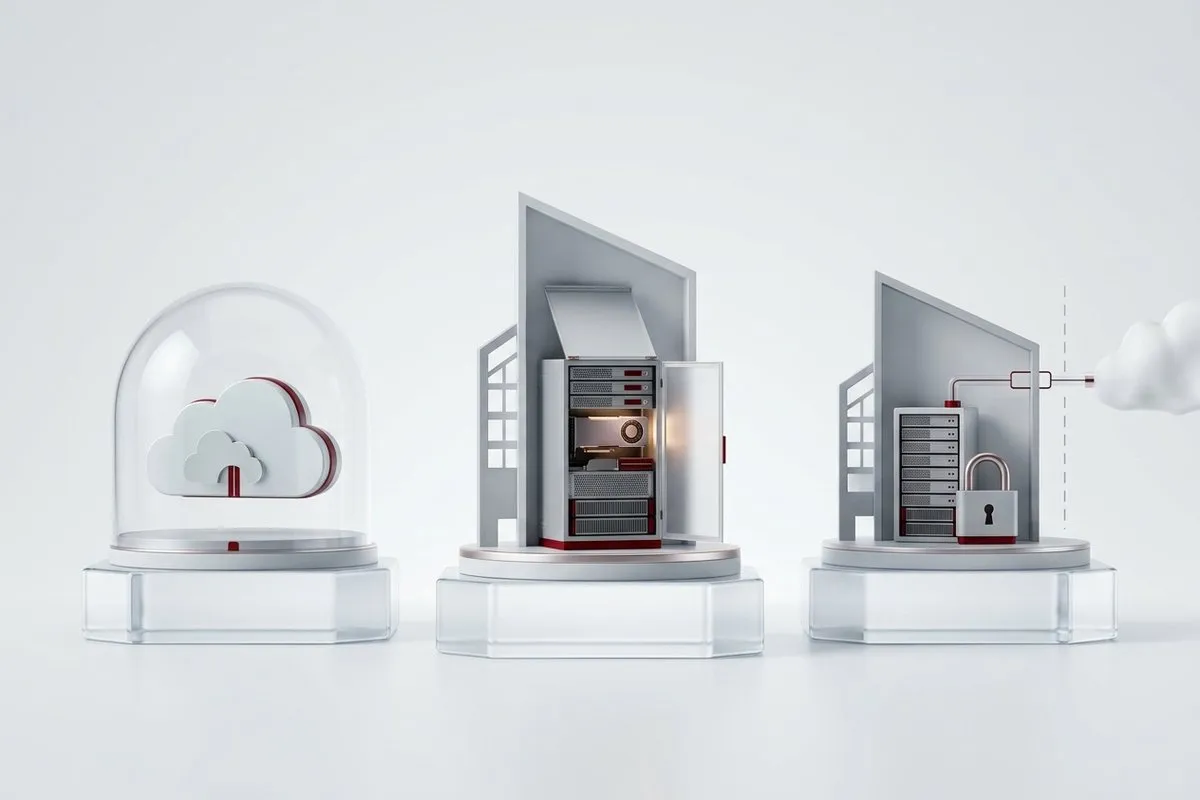
Este tipo de sistema se conoce como RAG (del inglés retrieval-augmented generation, generación aumentada por recuperación): el sistema recupera los fragmentos de la documentación que responden a la pregunta y el modelo redacta la respuesta a partir de estos. Cuando se prepara en servidores de la empresa, hablamos de RAG privado.
La misma base vectorial también sirve, sin redactar respuestas, para buscar por significado, relacionar datos o detectar duplicados (fichas de producto, perfiles y aptitudes, información técnica) dentro de una aplicación. Más detalles en IA integrada en aplicaciones.
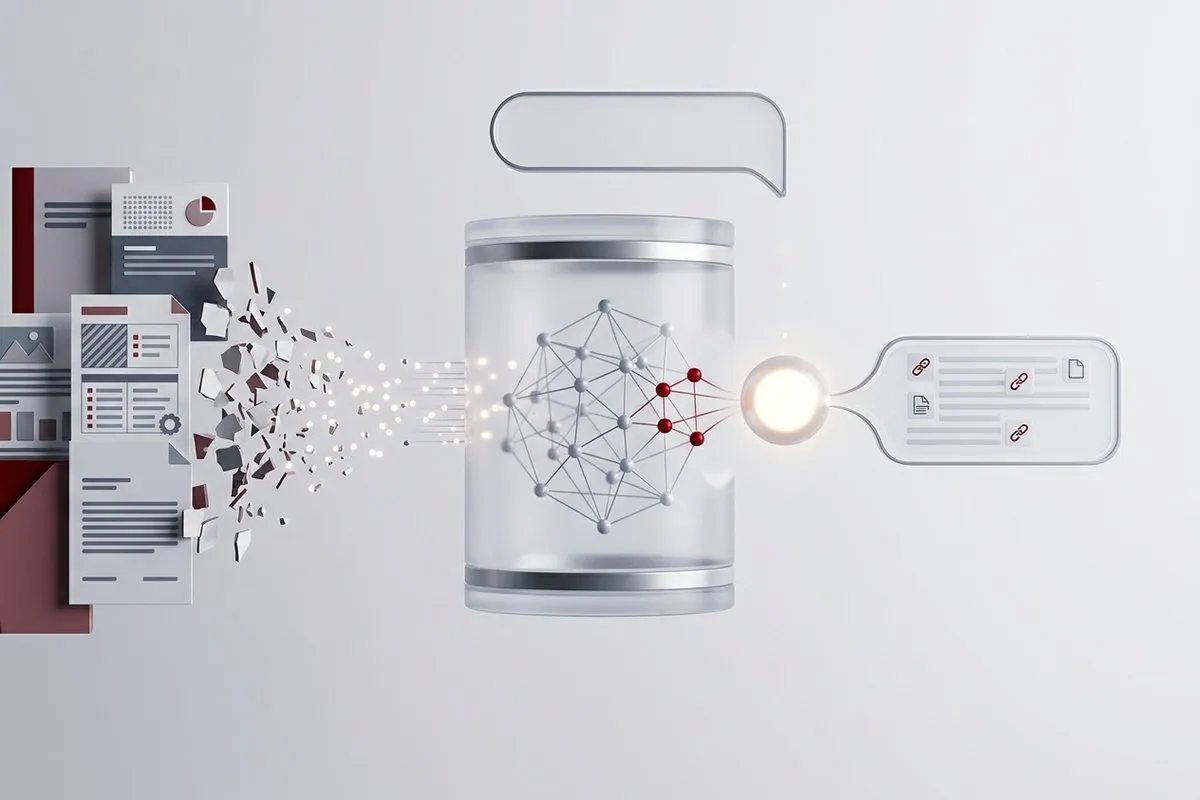
Cómo planteamos un RAG en Gilsys
Los seis componentes de un RAG privado sobre documentación interna
Del documento a la respuesta, todo dentro de la infraestructura de la empresa. Las tecnologías de cada componente son ejemplos: en cada proyecto se escogen según el tipo de documentación, el volumen y la máquina disponible. Se pueden sustituir cuando aparece una alternativa mejor.
1. Repositorio de documentos
Por ejemplo, ownCloud o Nextcloud
El gestor documental de la empresa almacena manuales, procedimientos, contratos, expedientes. Los documentos se conservan dentro del gestor.
2. Fragmentación y embeddings
Por ejemplo, bge-m3
Los documentos se dividen en fragmentos y cada uno se convierte en un vector (embedding), que representa su significado, no sus palabras exactas.
3. Base de datos vectorial
Por ejemplo, Qdrant
Una base de datos especial guarda esos vectores y ante una pregunta devuelve los fragmentos que más se le parecen en significado, filtrados por los permisos del usuario que lo solicita para no acceder a información fuera de su alcance.
4. Modelo de lenguaje
Por ejemplo, gpt-oss, Mistral o Qwen
Un modelo de lenguaje redacta la respuesta a partir de esos fragmentos y se le parametriza si debe ceñirse más o menos a ellos o indicar que no dispone de información concreta en caso de no encontrarla.
5. Servidor del modelo
Por ejemplo, Ollama o vLLM
Se ejecutan el modelo y los embeddings en la GPU del servidor. Según cuántas personas trabajen en paralelo, se requiere mayor o menor memoria y velocidad de procesado.
6. Interfaz de consulta
Por ejemplo, AnythingLLM o una interfaz a medida
Se ofrece una interfaz de chat desde donde el usuario accede y dispone de información acotada a su espacio de trabajo. Esta interfaz se puede desarrollar a medida e integrar funcionalidades avanzadas con programación a medida.
Cómo se usa un RAG privado: chat, flujos y APIs
Una interfaz de chat
Es necesario ofrecer una aplicación web interna o canales como Telegram, WhatsApp o Teams. Debe integrar memoria privada para cada conversación.
Flujos y automatizaciones
Mediante n8n o desarrollos a medida, automatizamos el flujo de ingesta continua de información: extraemos los datos, por ejemplo de aplicaciones y ficheros, los procesamos y los indexamos en una base vectorial para que el RAG pueda consultarlos sin intervención manual. Más detalles en automatizaciones con IA.
Una API a medida
El RAG puede usarse como un servicio propio, por ejemplo con FastAPI o Slim Framework, con un punto de acceso para indexar documentos y otro para consultar, al que se conectan herramientas como un ERP o aplicaciones y servicios a medida.
Caso real: IA privada en una entidad social
Cuando la información no puede salir de la organización
Una entidad sin ánimo de lucro quería consultar con inteligencia artificial su documentación privada. Estamos hablando de expedientes con datos muy sensibles, protocolos internos y códigos de conducta, información que consideraban sensible y que no querían transferir fuera de la entidad.
En este caso, todo funciona en servidores locales en la propia entidad. La documentación se centraliza en el gestor documental, el modelo, de código abierto, es ejecutado localmente y, además, cada departamento puede consultar la información mediante chat restringido dentro de los espacios de trabajo que tiene autorizados. Ningún dato sale de la organización.
Permisos gestionados en un solo sistema
La gestión de usuarios y permisos se concentra en el gestor documental y, mediante un desarrollo a medida, nuestro sistema propaga en tiempo real esa estructura de accesos a la base de datos vectorial y se encarga de reindexar automáticamente cada archivo actualizado, permitiendo que nadie pueda consultar información a la que no tenga acceso.
Validación mediante GPU de consumo
El proyecto se validó con una tarjeta gráfica de consumo, que permitía ejecutar el modelo, realizar los embeddings y testear algunas conversaciones simultáneas. El mismo proyecto, con más memoria, podrá ofrecer mayor contexto y recuperar más fragmentos en cada respuesta.
Indexación automática
Los documentos se indexan de forma desatendida, sin interrumpir el uso del asistente. En las pruebas, indexar varios miles de documentos públicos de muestra requirió casi un día de procesado.
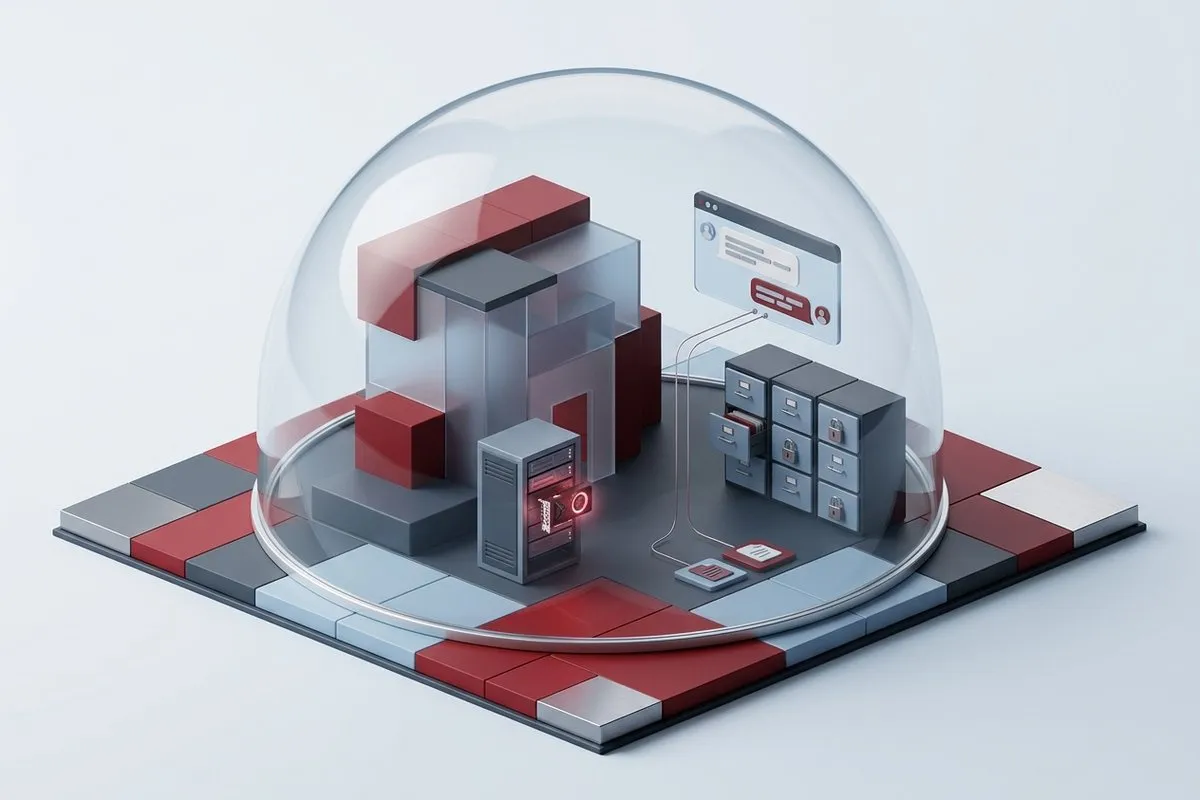
Cómo implantamos una IA privada en una empresa
Analizamos los requisitos concretos y ofrecemos diferentes alternativas tecnológicas, partiendo potencialmente de herramientas de código abierto sin licencias recurrentes, con posibilidad de ampliar mediante desarrollos a medida.
Antes de empezar: la información, bien organizada
Una IA privada trabaja con los datos de la empresa tal como están. Antes de empezar a trabajar con la información, es necesario realizar un inventario de la información disponible, ubicación, calidad y permisos vinculados. Si no está bien organizada, el primer paso es de gobierno del dato para organizarla y de gestión documental en caso de documentación.
Análisis del uso y los procesos
Se determina con qué finalidad necesita la IA acceder a la información: consultar documentación, clasificar o trabajar dentro de agentes y automatizaciones. En base al análisis se recomienda un servidor en la empresa, una nube privada, arquitectura mixta o IA comercial.
Elección del modelo y la infraestructura
Qué modelo encaja con el uso y el idioma y qué máquina necesita para responder en un tiempo razonable.
Conexión con los datos, sin entrenar el modelo
El modelo no se entrena con la información de la empresa: se conecta a ella. Si tiene que responder con documentación, los documentos se dividen en fragmentos, se convierten en vectores y se indexan por espacios de trabajo; si trabaja con herramientas internas como ERP o CRM, la consulta de datos se realiza directamente, limitando los permisos de cada usuario.
Integración con las herramientas de la empresa
Desarrollamos la interfaz de consulta y la conectamos con aplicaciones, agentes y flujos de trabajo. Para evitar duplicidades, los usuarios y sus permisos se sincronizan desde un único punto.
Pruebas en tres niveles
Una respuesta generada por IA no se valida comparando el texto palabra por palabra. Se comprueba en tres niveles antes de publicar cualquier cambio. Primero, tests automáticos que verifican que los documentos se segmentan bien, que se aplican los permisos de cada usuario, que se citan las fuentes y que el motor recupera los fragmentos correctos. Después, una IA de decisión como Jev evalúa cada respuesta: confirma si lo que afirma realmente se encuentra en los documentos, si responde a lo que se ha consultado y si descarta alucinaciones. Por último, entre 50 y 100 preguntas reales de la empresa, validando las respuestas de forma manual. Cada vez que se cambia el modelo, el prompt o la documentación, se debe volver a ejecutar la batería de pruebas para validar que el resultado no se desvíe del umbral fijado.
Mantenimiento
Se puede acotar una partida periódica con tareas acotadas, aunque depende de las capacidades del equipo de IT de la empresa cliente. Es importante reiterar que cada vez que se actualice el modelo, se vuelva a ejecutar la batería de pruebas.
Preguntas frecuentes sobre IA privada
¿Qué es una IA local y en qué se diferencia de una IA privada?
¿Alguna norma obliga a tener la IA en servidores privados?
¿Una IA privada sirve también para agentes y automatizaciones?
¿Qué máquina hace falta para una IA privada?
Depende principalmente de dos factores: las personas que van a usar el sistema en paralelo y el tamaño del modelo (número de parámetros). Un modelo con más parámetros es más completo, pero necesita más memoria en la tarjeta gráfica y cada usuario simultáneo consume más carga. Como orientación:
- Tareas básicas o un asistente con pocas personas a la vez: una tarjeta gráfica de consumo de 24 o 32 GB, en la que cabe un modelo como gpt-oss-20b, que según OpenAI funciona con 16 GB.
- Más usuarios simultáneos o modelos más capaces: una de 48 GB.
- Un modelo grande, como gpt-oss-120b: una de 80 GB.
En la nube, en RunPod por ejemplo, una tarjeta gráfica de 24 GB cuesta entre unos 0,30€ y 0,79€ la hora y una de 80 GB, entre unos 1,06€ y 1,60€ como datos indicativos. De todos modos, en cada proyecto se valoran diferentes alternativas de máquinas.
¿Se puede apagar la máquina en la nube cuando no se usa?
¿Cuánto se tarda en implantar una IA privada?
¿Cuánto cuesta una IA privada?
Desplegar una IA privada tiene dos costes: el de implantación y el de la máquina. El trabajo depende del tipo de proyecto:
- Solo el modelo, para que lo usen aplicaciones, agentes o automatizaciones. En este caso, se evalúa dentro del presupuesto de cada aplicación que lo requiera. El coste no está en instalar el modelo, sino en preparar y proteger la API que lo usa y en desarrollar esa API o la aplicación vinculada correspondiente al proyecto.
- Un asistente chat sobre la documentación de la empresa (RAG): como orden de magnitud, de 5.000€ a 12.000€.
- Proyectos más amplios, que conectan la IA privada con varios sistemas de la empresa o se integran dentro de herramientas y aplicaciones como servicios, se presupuestan a medida, según requisitos específicos.
El servidor se compra o se alquila aparte, como se explica en la pregunta sobre la máquina. Son cifras orientativas. Solicitar presupuesto es gratuito y sin compromiso.
¿Qué documentación debería poder consultar el equipo?
Con la documentación que hay y lo que se quiere poder preguntar, vemos qué hace falta y si conviene un servidor en la empresa o una nube privada.